注目のトピック
特集:Reinforcement Learning
4件の記事


 AI Development
AIは「教わる」から「試す」へ、なぜ学習方法を切り替えられるのか
AIは、人間のお手本を真似する模倣学習から、自分で試行錯誤する強化学習へ移行できます。本記事では、両者が同じモデルの行動確率を調整する学習としてつながる理由、なぜ模倣学習を先に行うと有効なのか、切り替え時に起こる失敗や対策、ロボットや対話AIでの応用まで整理します。
Toshihiko Nagaoka
 AI Development
Isaac Simは激重なUnityではない - ML-Agentsから移行すべき決定的な4つの理由
Isaac SimとUnity ML-Agentsは、どちらも強化学習環境を構築できますが、設計思想と得意領域は大きく異なります。本記事では、GPU並列化、接触力学、Domain Randomization、センサー生成、ROS 2・URDF・USD連携の4領域を中心に比較し、Sim-to-Realを前提としたロボット開発でIsaac Simが強い理由と、Unityが適するケースを整理します。
Toshihiko Nagaoka
 AI Development
強化学習とは何か - あの「超次元格闘」の裏で何が起きていたのか?
強化学習は、正解データを真似するのではなく、試行錯誤を通じて報酬を最大化する行動を学ぶ機械学習手法です。本記事では、NVIDIA Isaac Simのロボット相撲実験を例に、State・Action・Environment・Rewardの基本構造、教師あり学習との違い、AIがラリアットや空中戦といった予想外の戦略を獲得した理由を解説します。
Toshihiko Nagaoka
 AI Development
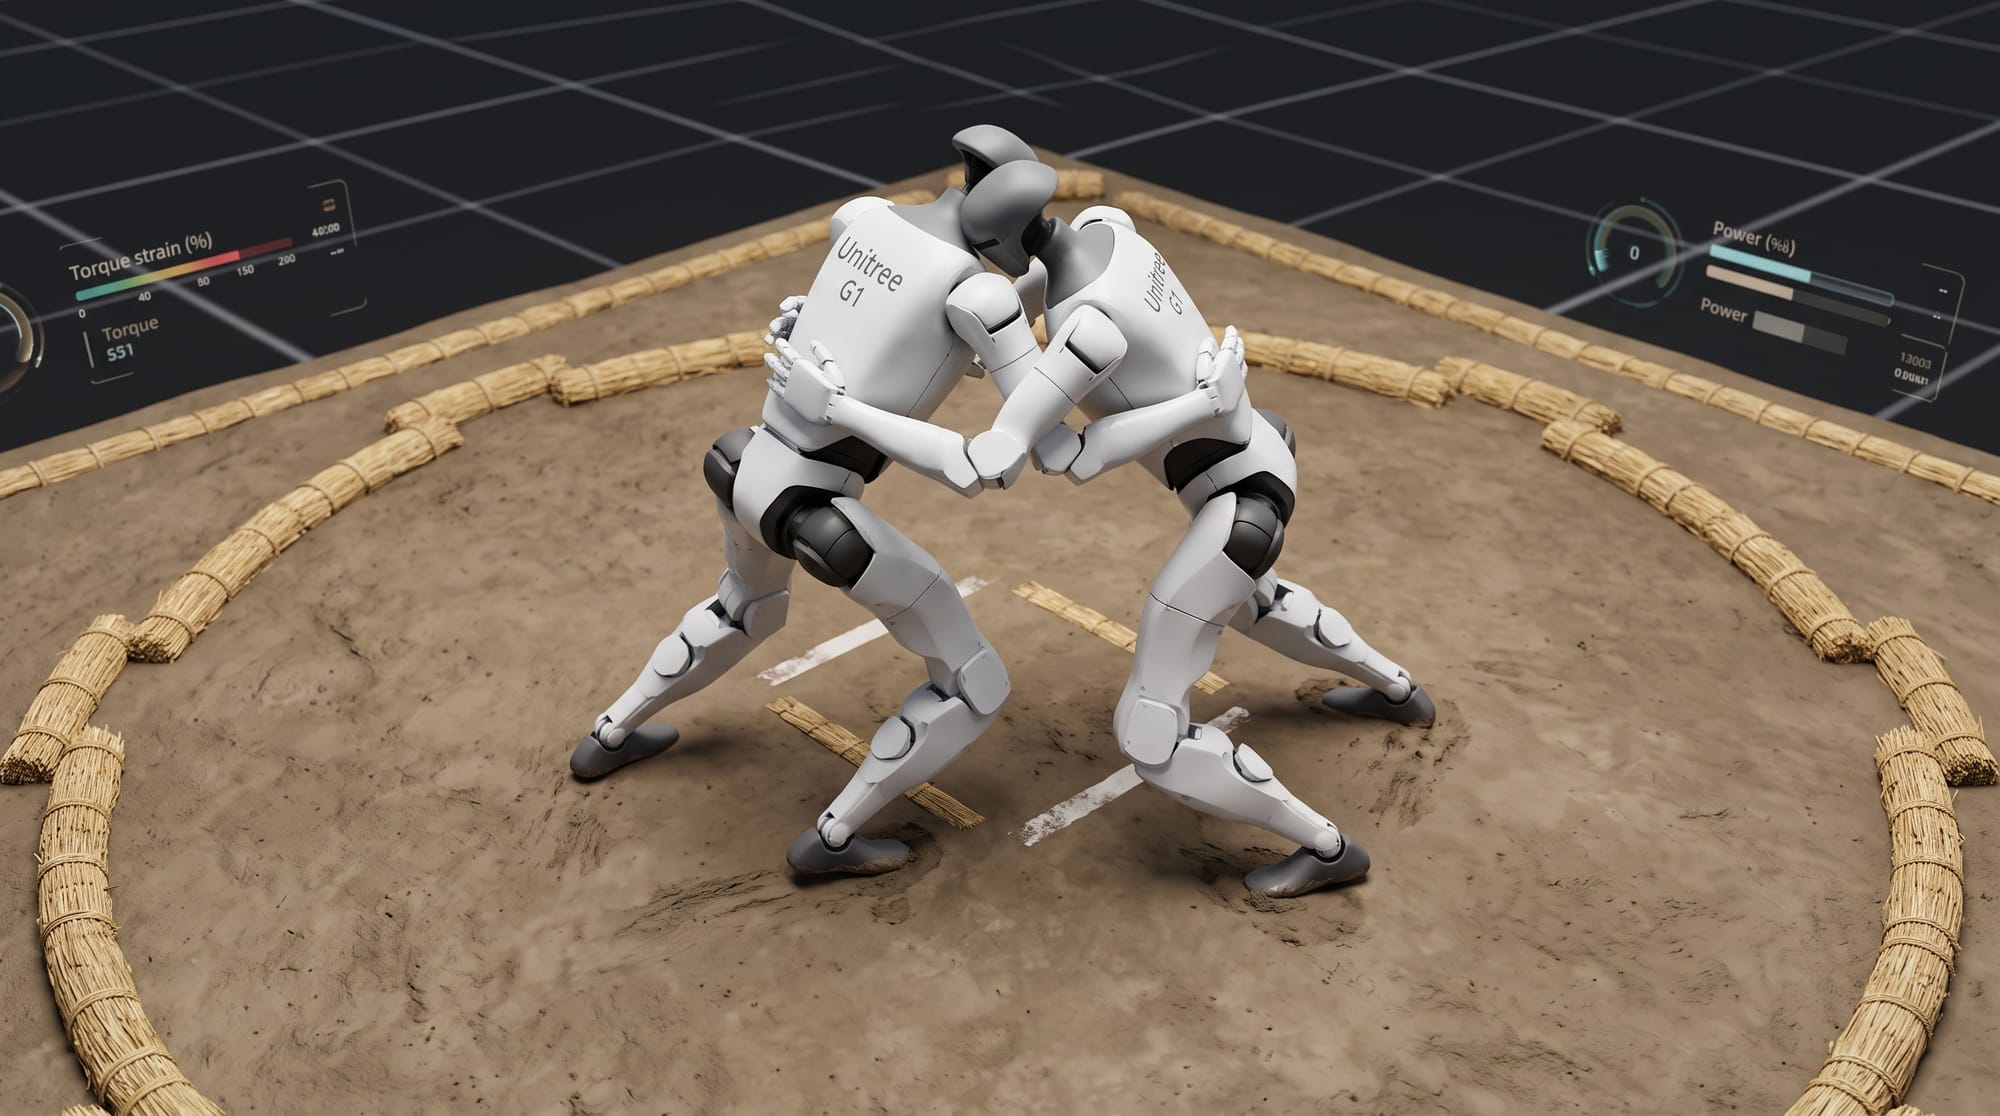
ロボットに相撲を教えてみたら、ラリアット・コサックダンス・空中戦を極めた件
NVIDIA Isaac Sim上で2台のロボットに相撲を学習させた強化学習実験を紹介します。Epoch 1から100までの進化を追いながら、Isaac Simを使う理由、Sim to Real、Domain Randomizationの考え方、そしてAIがラリアット・足技・空中戦といった予想外の戦略を獲得していく過程を解説します。
Toshihiko Nagaoka
